IBM Research вытащила на свет дырку, которую удобно прятать за красивым средним процентом: AI-агент может пройти задачу, а потом на том же самом запросе поехать в другую сторону. Не «пользователь не так спросил». Не «среда поменялась». Просто внутри цепочки решений было место, где выбор почти ничейный.
На AppWorld это выглядит бодро и грустно одновременно. ReAct-агент на GPT-4.1 в пяти повторах давал средний успех 77,4%. Но все пять раз подряд он проходил одну и ту же задачу только в 53,0% случаев. Разрыв — 24,4 процентного пункта, а на сложных задачах он доходил до 30. Вот почему «в демо сработало» — так себе гарантия для продакшена.
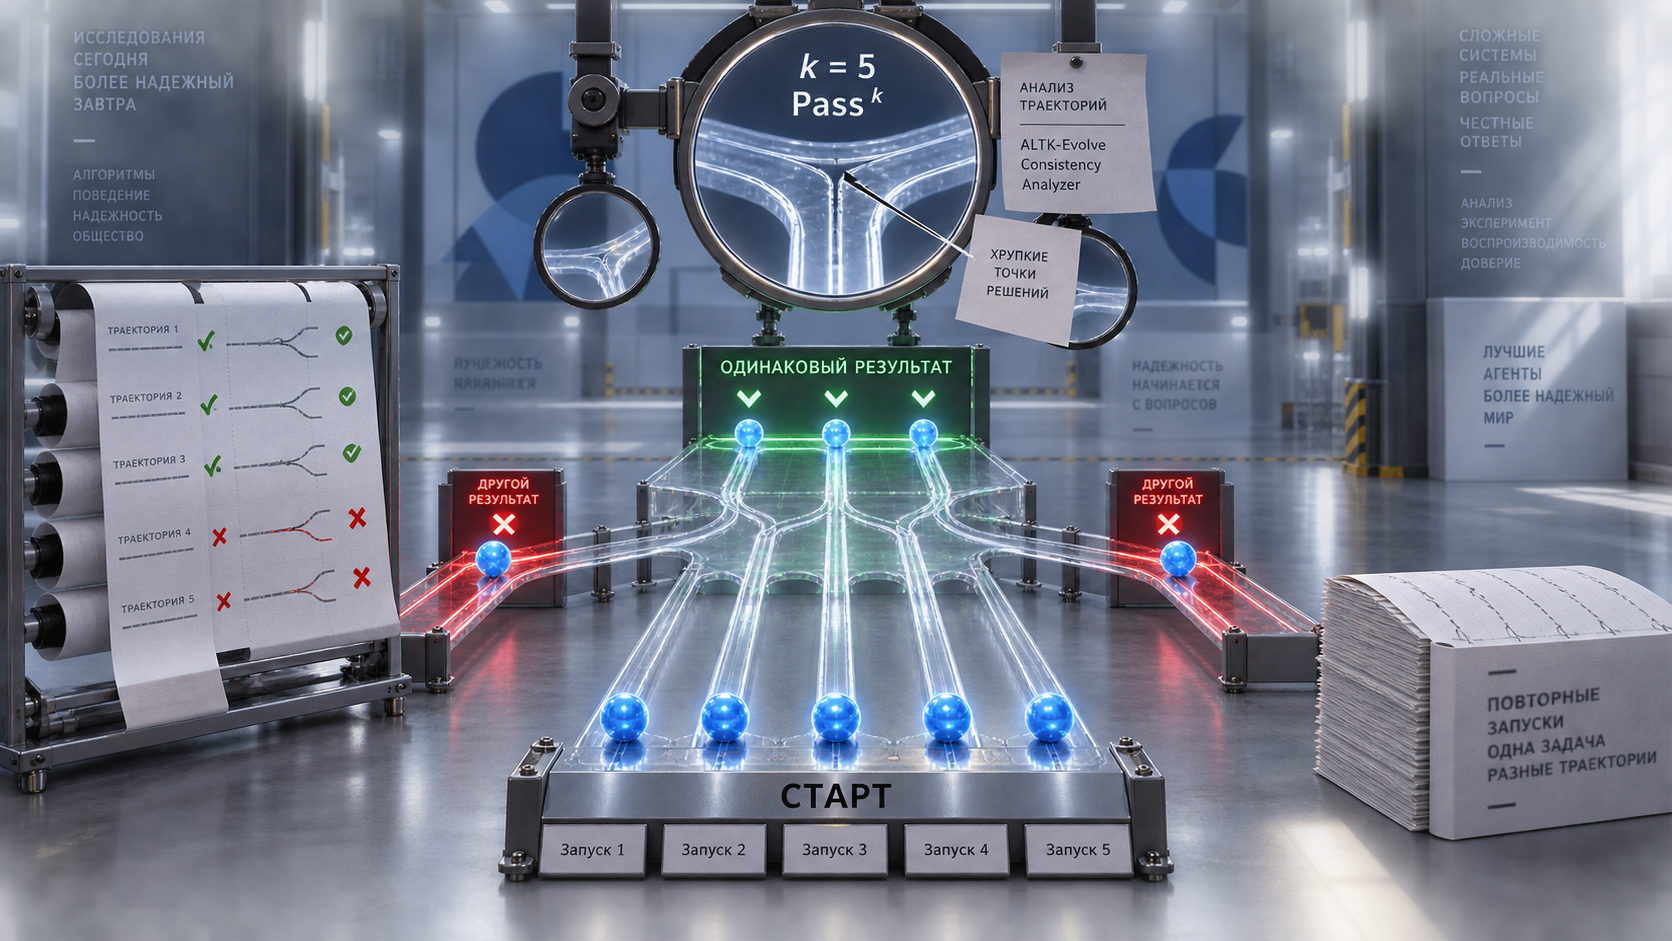
IBM называет нужную метрику Pass^k. Это не Pass@k, где можно радоваться, если из нескольких попыток хоть одна попала. Тут наоборот: задача считается надёжной только если агент выдержал все k запусков. Для агента, который сверяет платёж, ищет обязательство в договоре или дёргает API по цепочке, это ближе к жизни. Пользователю не нужна рулетка с табличкой «ну вообще-то среднее хорошее».
Новая часть ALTK-Evolve — Consistency Analyzer и consistency guidelines. Анализатор берёт уже записанную траекторию агента и проверяет отдельные точки выбора: где модель могла легко выбрать другой токен, другой инструмент или другой аргумент. Ему не нужны логиты, доступ к внутренностям модели и новый полный прогон задачи. На каждом шаге он запрашивает несколько вариантов ответа, по умолчанию k=5, и ищет места, где решение держится на тонкой ножке.
Потом эти слабые места превращаются в короткие правила для следующих запусков. То есть ALTK-Evolve не просто вытаскивает полезные уроки из прошлых траекторий ради среднего качества, а отдельно бьёт по повторяемости: чтобы агент не был отличником один вторник из трёх.
Есть и холодный душ. Это результаты IBM Research, опубликованные в блоге Hugging Face; независимой репликации в сохранённом материале нет. Метод требует записанных трасс и офлайн-анализа, а не волшебной кнопки «сделать надёжно». И даже temperature 0.0 не спасает, если в hosted-модели рядом стоят почти равные варианты: маленький сдвиг — и агент уже пошёл другой тропой.
Зато подвох теперь хотя бы можно поймать за руку. Не смотреть только на «77,4% в среднем», а спросить: повторит ли он это завтра, когда рядом не будет инженера с огнетушителем?