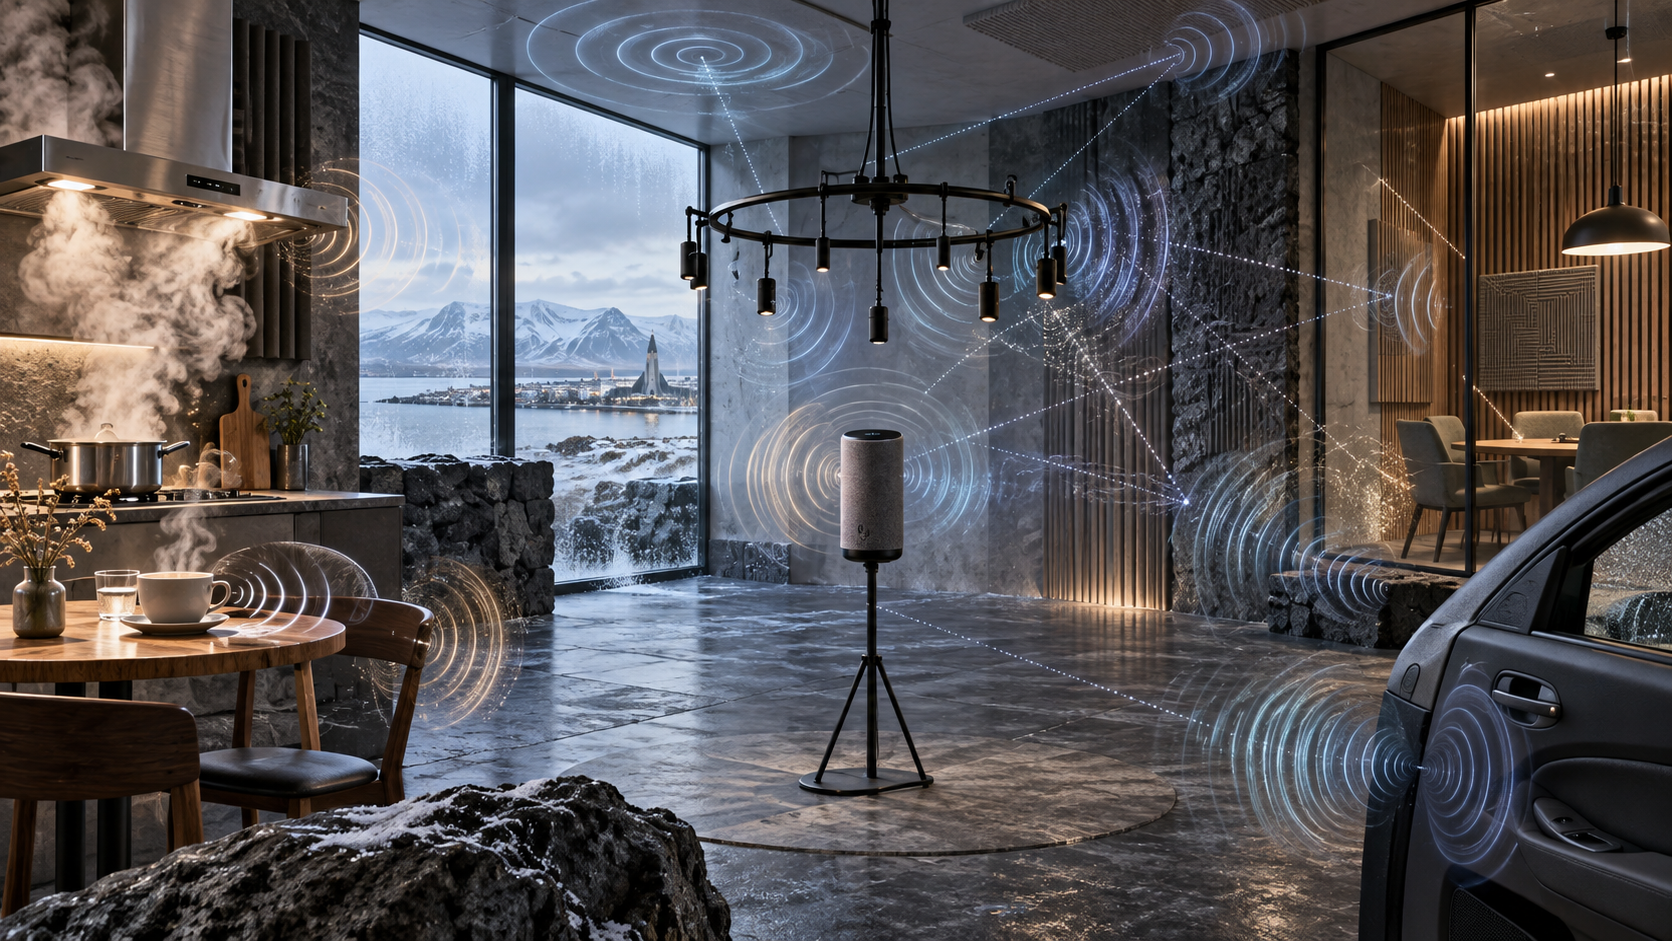
Исландская Treble взяла ещё $18 млн и хочет стать той самой техкомнатой, где голосовые модели гоняют не в стерильной тишине, а в нормальной жизни: шум, эхо, расстояние до микрофона, люди рядом, колонка стоит не там, где мечтал инженер.
Раунд — расширение Series A. Ведёт Paladin Capital Group, старые инвесторы KOMPAS VC, Frumtak Ventures, EIC и Omega ehf тоже зашли. До этого у Treble были $12 млн в 2024 году, теперь общий объём привлечённых денег — больше $40 млн. Для стартапа из Рейкьявика, основанного в 2020-м двумя акустическими инженерами, это уже не история «ребята пилят демку в гараже». Среди клиентов названы Amazon и Logitech — то есть люди, у которых микрофоны, колонки и наушники не в презентациях, а на миллионах столов.
Суть Treble простая: вместо бесконечно записывать реальные комнаты, кафе и переговорки, платформа физически симулирует звук. На этих данных можно тренировать и проверять распознавание речи, шумодав, голосовые модели и железо. Для разработчика это примерно как краш-тест, только не машина в стену, а голосовая система в ресторан, офис, машину или комнату с мерзким эхом.
Здесь важен не сам чек на $18 млн, а куда рынок смотрит. Голосовые интерфейсы снова лезут везде: очки, наушники, роботы, автомобили, умные колонки. А потом выясняется знакомое: в красивом ролике ассистент всё слышит, а на кухне с вытяжкой — уже как дедушка на лавочке.
Контекст тоже есть. Treble вместе с Hugging Face запустила FFASR Leaderboard — бенчмарк для распознавания речи в дальнем поле: чистый звук, шум, реверберация и прочие радости реального помещения. Это полезнее, чем мерить модель только на записи, где человек говорит прямо в микрофон, как на экзамене.
Границы у истории такие: Treble не выпустила новый потребительский гаджет и не обещает, что завтра наушники начнут слышать «сверхчеловечески». Деньги идут в инфраструктуру для тех, кто такие штуки делает. Цены платформы, условия доступа и конкретные новые продукты после раунда не раскрыты. Но сигнал понятный: голосовой AI упёрся не только в модель, а в акустику. И вот за эту скучную, но очень настоящую проблему инвесторы уже платят.